Loop 首先是一套研发操作系统
它要自动提出问题、执行实验、判断结果并把经验写回模型或工具链。只要最后一步仍靠少数创始人拍板,复利速度就受人类判断带宽限制。
LINJUNKAI.COM / FRONTIER AI RESEARCH / 2026.07.05
对 Ricursive Intelligence、Mirendil 与 Core Automation 的技术路径、资本逻辑和竞争边界进行拆解,并回答一个更现实的问题:拥有强化学习环境的创业公司,何时需要训练自己的模型?
2025 年 12 月至 2026 年 6 月,三家新实验室相继成立或公开亮相;7 月 Core Automation 又被私募数据库记录完成新一轮融资。按现有公开与公司文件数据库口径,三家公司累计融资至少 11.35 亿美元,最近一轮估值合计约 86.2 亿美元。它们都在讲 Loop,也都把模型训练写进长期路线,由此在 Google、Meta 与 OpenAI、Anthropic 之外形成一条新的融资路径。对中国市场而言,这更像一个提前 6–12 个月出现的估值信号。
Executive view
三家公司共享“自我加速”的语言,底层资产和风险结构差异很大。投资判断需要把 Loop 拆成环境、评价器、数据和更新机制,才能识别真正可复利的部分。
它要自动提出问题、执行实验、判断结果并把经验写回模型或工具链。只要最后一步仍靠少数创始人拍板,复利速度就受人类判断带宽限制。
芯片的时序、面积、功耗和可制造性可被硬指标验证;开放式 AI 研究的方向价值难以即时判定。评价信号越硬,自动改进越容易持续。
Google、Meta、OpenAI 与 Anthropic 均已公开自我改进系统。新实验室的机会来自客户中立性、垂直环境、专有反馈和组织速度。
创业公司可以先用外部模型建立产品、环境与评价体系。当真实使用产生稳定奖励和专有 on-policy 数据,后训练与自有模型开始获得经济价值。
私营公司数据存在信息滞后。下表区分官方公告、可靠媒体与基于公司 Certificate of Incorporation 的私募数据库记录;谈判中的估值单独标记。
| 公司 | 成立 / 公开 | 最近已完成融资 | 最近已完成估值 | 后续目标 | 证据 |
|---|---|---|---|---|---|
| Ricursive Intelligence芯片设计 Loop | 2025.12 公开成立 | $300M Series A;累计 $335M | $4.0B post-money | 未披露 | 官方已完成 |
| MirendilAI R&D Loop | 2025.12 设立;2026.06 公开 | $200M Seed | $1.0B post-money | 未披露 | 官方 / 交叉核验 |
| Core Automation自动化实验室 Loop | 2026.03 下旬成立 | $500M(2026.07);累计 $600M | $3.62B post-money | 2026.05 曾目标 $300M–$500M、约 $4.0B | Forge / COI 数据 公司未公告 F |
Core Automation 的实色条采用 Forge 依据公司提交 Certificate of Incorporation 记录的 2026 年 7 月 post-money;虚线框保留 5 月约 40 亿美元的谈判目标。
Ricursive Intelligence 与 Mirendil 来自官方 / 交叉核验;Core Automation 实色来自 Forge 公司文件数据库,虚线为此前媒体报道目标。
$35M Seed,媒体报道 post-money $750M。
特拉华州登记时间来自 The Information。
$300M,post-money $4.0B,四个月累计 $335M。
由前 OpenAI 研究负责人 Jerry Tworek 发起。
此前已融 $100M;拟融 $300M–$500M,目标约 $4.0B。
$200M Seed,post-money $1.0B,团队约 20 人。
Forge:$500M、post-money $3.62B;公司未公告。
Analytical framework
“模型写代码”只覆盖执行环节。完整 Loop 还要回答谁提出值得做的问题、在哪个环境运行、如何判定改进,以及改进怎样进入下一代系统。
结果被写回问题生成、工具链和模型权重,下一轮在更高起点开始。
The evaluator is the ceiling
近期递归自我改进综述把“验证信号”放在中心位置:形式化验证与可执行测试最可靠,开放式方向判断最脆弱。奖励一旦偏离真实目标,Loop 会加速放大奖励投机、数据坍缩或研究路径收敛。
技术综述 这一框架也解释了三家公司为何具有不同的可验证性与估值风险。I7
| 公司 | 环境 | 评价信号 | 写回对象 | 当前公开证明 |
|---|---|---|---|---|
| Ricursive Intelligence模型 ↔ 芯片 | 芯片设计、布局布线、验证与最终流片 | PPA、时序、线长、验证结果、制造约束 | 设计策略、EDA 流程、AI 模型,长期包括自研芯片 | 强 AlphaChip 已用于多代 TPU;公司产品仍早期 |
| Mirendil模型 ↔ AI R&D | 实验代码、训练集群、模型 checkpoint 与评测 | 实验指标、回归测试、算力效率、研究者判断 | Agent harness、数据、后训练策略与 frontier model | 中 依赖团队在 Anthropic / Google / xAI 的前史 |
| Core Automation模型 ↔ 实验室 | 系统代码、研究流程、学习算法与组织运行 | 可执行测试与开放式研究价值的混合信号 | 系统工具、学习算法、架构与实验室操作方式 | 早期 官网 thesis 与一篇系统研究文章 |
Company deep dives
以下每家公司先给出可核验事实,再分析 Loop 的技术闭合程度、商业化路径、竞争条件与尚未被证明的部分。
从芯片设计切入,用可测量的物理反馈训练端到端 AI,长期让模型与硬件共同演化。
芯片设计具备大规模强化学习需要的三项条件:问题价值高、搜索空间巨大、评价信号可计算。AlphaChip 已证明强化学习可以把芯片 floorplanning 视为序列决策问题,并在数小时内生成生产级布局。Google 表示该方法用于 TPU v5e、v5p 与 Trillium 等多代设计。R6
Ricursive Intelligence 把这个局部成功扩展到端到端设计:模型读取 workload 与设计目标,生成并验证越来越完整的芯片方案;新方案继续产生训练数据。公司将目标客户定义为拥有高价值计算 workload、缺少完整芯片团队的企业,也会服务现有芯片厂商。R5
短期产品形态更可能是高价值设计项目、软件平台与计算服务的混合体。客户在早期需要人工专家兜底,公司也需要接入 Cadence、Synopsys 与代工厂的既有工具链。随着端到端覆盖率提升,收入可向订阅、按设计阶段收费或芯片价值分成迁移。
对 Google 的主要优势是客户中立性。芯片公司不会轻易把最敏感的设计数据交给潜在竞争者;独立公司更容易成为跨客户的平台。对 OpenAI 与 Anthropic 的优势来自环境专有性:通用模型可以写 RTL 或调用工具,却缺少贯穿验证、工艺和流片结果的训练闭环。
这是三家公司中证据链最完整的一家:创始团队有生产级前史,评价信号最硬,目标市场的时间与人力成本足够高。40 亿美元估值购买的是“从局部生产验证扩展到全流程”的期权。
芯片客户数据难共享,流片反馈周期长,制造能力掌握在代工厂手中。AlphaChip 的 floorplanning 成功无法自动推出 end-to-end 芯片设计成功;公开资料尚未披露命名客户、流片项目或可购买产品。
训练擅长 AI R&D 的 frontier models,并把内部大模型实验室的全套研究系统产品化给外部团队。
Mirendil 的出发点是,大型模型公司已经在内部用 AI 加速 AI 研发,但缺少把这套能力开放给竞争者的商业激励。公司希望把“会做 AI 研究的模型”及其运行栈提供给工程师、研究者,随后扩展到科学家和其他领域专家。M2
创始团队的卖点集中在 insider knowledge。Harsh Mehta 被投资方描述为 Anthropic 首个自动化 AI R&D 平台的发起者;Behnam Neyshabur 曾参与 Google Blueshift、Minerva / Gemini 以及 Anthropic Discovery;Shayan Salehian 来自 xAI 的后训练、推理和 Agent 团队;Tara Rezaei 有 OpenAI 学生研究与竞赛背景。M3
Mirendil 最清晰的产品路径是“AI R&D cloud”:按席位、算力或实验吞吐收费,让不具备 frontier-lab 基础设施的团队获得同类能力。客户可能包括模型创业公司、AI for Science 团队与大型企业研究院。
相较 OpenAI 与 Anthropic,Mirendil 的可销售对象可以覆盖这些模型公司的潜在竞争者;相较 Google,独立平台更容易兼容多种模型和云。它需要证明外部客户的研究环境可以被标准化,同时保留足够的领域差异。
10 亿美元估值主要建立在团队曾经搭建内部自动研究系统的经历,以及“内部能力外部化”的平台机会。若 Mirendil 掌握跨客户的实验轨迹、失败样本与算力调度数据,其数据飞轮可能比单一模型 checkpoint 更难复制。
公司尚未公开产品、客户、benchmark 或技术报告。AI 研究方向的长期价值难以即时验证,客户数据又可能无法跨组织共享。头部实验室也会持续强化内部工具,Mirendil 必须在外部市场形成足够大的数据优势。
从组织、系统和学习算法同时重构 AI 实验室,押注持续学习与 transformer 之后的新架构。
Core Automation 对当前 recipe 的判断最激进:更大模型、更多数据和静态部署不会自然带来下一次跃迁。官网提出开发超越大规模预训练与现有强化学习的新学习算法,并寻找比 transformer 更可扩展的架构。实验室本身从第一天就围绕 capable agents 设计。C1
The Information 报道称,Jerry Tworek 希望让模型在真实使用中持续学习,把预训练、后训练和部署之间的边界压缩,并以更少数据获得能力提升。团队还吸引了 Rohan Anil、Joanne Jang、Anmol Gulati、Julia Villagra 等来自头部实验室的人才。C3
2026 年 5 月,公司被报道拟融资 3 亿至 5 亿美元、目标估值约 40 亿美元。Forge 随后记录一笔 7 月 15 日的 5 亿美元 Series Seed,post-money 约 36.2 亿美元,并说明该估值依据公司提交的 Certificate of Incorporation。公司尚未发布融资公告,投资方未披露。C4
Core Automation 公开的第一篇技术文章聚焦系统代码自动化。文章使用 GPU kernel 竞赛说明一个关键问题:模型会利用 evaluator 的漏洞获得虚假加速,因此需要 problem author、competitor、cheater 与 auditor 多角色互相攻击和校验。这个案例给出了评价器工程的具体思路,也暴露了开放式自动研究中最难的环节。C2
公司目前没有接近发布的公开产品,近期产出首先服务内部实验室。长期商业化可能来自基础模型 API、持续学习平台、研究自动化系统或由这些能力孵化的垂直产品。由于路径尚未确定,估值更接近对团队和范式突破的组合期权。
Core Automation 与 OpenAI、Anthropic 的竞争最直接:它需要训练自有模型并证明新的学习机制。面对 Google 与 Meta,它缺少既有算力、海量产品反馈和研究基础设施,最重要的组织优势是允许高风险方向占据公司主线。
Core Automation 的故事把研究方法、模型架构和公司组织绑在一起。若持续学习成立,数据效率与部署更新速度可能同时改善;若核心算法没有突破,自动化实验室仍可能成为有价值的研究基础设施。
公开技术证据最少,最新融资也未由公司宣布。Forge 的 36.2 亿美元 post-money 基于公司文件数据库,可信度高于市场传闻,仍缺少投资方与交易条款的公开确认。公司尚未发布模型、benchmark、客户或完整技术报告。
Cross-company comparison
| 维度 | Ricursive Intelligence | Mirendil | Core Automation |
|---|---|---|---|
| 起点 | 芯片设计中的强化学习生产前史 | 头部实验室内部 AI R&D 系统经验 | OpenAI 推理模型与跨实验室研究人才 |
| Loop 对象 | 模型与硬件 | 模型与 AI 研究过程 | 模型、学习算法与实验室组织 |
| 评价器硬度 | 高:PPA、时序、验证、制造约束 | 中:实验指标可测,方向价值仍需判断 | 混合:系统指标硬,范式突破高度开放 |
| 产品路径 | 芯片设计平台 / 项目 / 计算服务 | AI R&D cloud / Agent / frontier model | 模型 API、持续学习平台或研究基础设施 |
| 数据资产 | 真实设计约束、验证轨迹、跨芯片迁移 | 实验成功与失败轨迹、checkpoint 比较 | 系统优化、研究过程和持续学习经验 |
| 资本用途 | 研究人才、EDA / 计算、客户项目与流片 | 算力、模型训练、实验平台与人才 | 高风险基础研究、算力与研究团队 |
| 近期验证点 | 命名客户、端到端覆盖率、首个流片结果 | 公开产品、第三方 benchmark、付费研究团队 | 技术报告、模型或算法增益、融资是否完成 |
Competition
自我改进并非创业公司的独家方向。竞争焦点集中在算力、基础模型、环境、评价器、客户数据和研究方向判断六类资产,胜负条件需要逐项比较。
自有数据中心、芯片、云平台和全球采购能力,可同时运行基础模型与自动研究系统。
新实验室通常先租用或采购 Nvidia 计算。
把有限算力投入芯片、AI R&D 或持续学习,避免维护大规模消费者产品与多条模型线。
搜索、社交、代码、企业 API 与内部研究团队持续产生反馈,且可直接部署新 checkpoint。
决定哪些行为会产生可信奖励。
进入客户 EDA、实验集群或专有工作流,建立巨头 API 看不到的任务轨迹和失败数据。
模型能力、API、云和应用在同一体系中,性能改进可以迅速覆盖庞大用户。
谁掌握任务定义、反馈和切换成本。
服务模型公司或芯片公司的竞争者,承诺客户数据隔离,并根据任务选择最佳底座。
拥有从基础研究到大规模部署的完整团队,也能内部孵化 AlphaEvolve、HyperAgents 等项目。
选择下一项值得做的研究仍是瓶颈。
高风险方向可以成为公司主线,组织无需兼容既有产品路线、季度目标和安全发布节奏。
新实验室无法在横向算力、数据和分发上正面对冲。可行路径是进入大厂缺少中立性的客户环境,或选择大厂组织难以长期集中资源的高风险范式。Ricursive Intelligence 的独立芯片设计平台与 Core Automation 的新学习算法分别对应这两类机会。
模型 API 会持续降价、提升能力,通用 Agent 层容易被压缩。新实验室需要控制可产生专有训练信号的环境,并拥有评价器和部署路径。Mirendil 的竞争力取决于外部 AI 团队是否愿意把完整研究过程交给它。
Incumbents already loop
2026 年,四家巨头均公开了内部或研究级自我改进证据。创业公司需要证明其 Loop 在特定环境中的反馈质量、更新速度或商业可访问性更强。
Build or buy the model?
必要性取决于环境能否持续产生专有、可信、接近真实分布的训练信号。模型训练应当沿着资产成熟度逐级上移,避免在产品和评价器尚未稳定时承担基础模型成本。
验证需求、任务分布与用户工作流,保留多模型路由能力。
进入下一阶段:模型调用成本或稳定性开始影响产品。搭建工具、沙箱、数据管道、任务生成和回归评测;形成专有轨迹。
进入下一阶段:奖励与用户结果有稳定相关性。针对真实环境调整行为、成本与速度,保持数据尽量 on-policy。
进入下一阶段:底座能力或许可限制成为主要瓶颈。强化代码、芯片或科研知识,优化推理成本,并让模型适配自有工具。
进入下一阶段:架构与学习机制本身就是公司核心 thesis。获得最大控制权,也承担数据、算力、人才、可靠性与分发的完整成本。
适用于模型能力本身构成产品和长期研究壁垒的公司。Case study / Cursor Composer
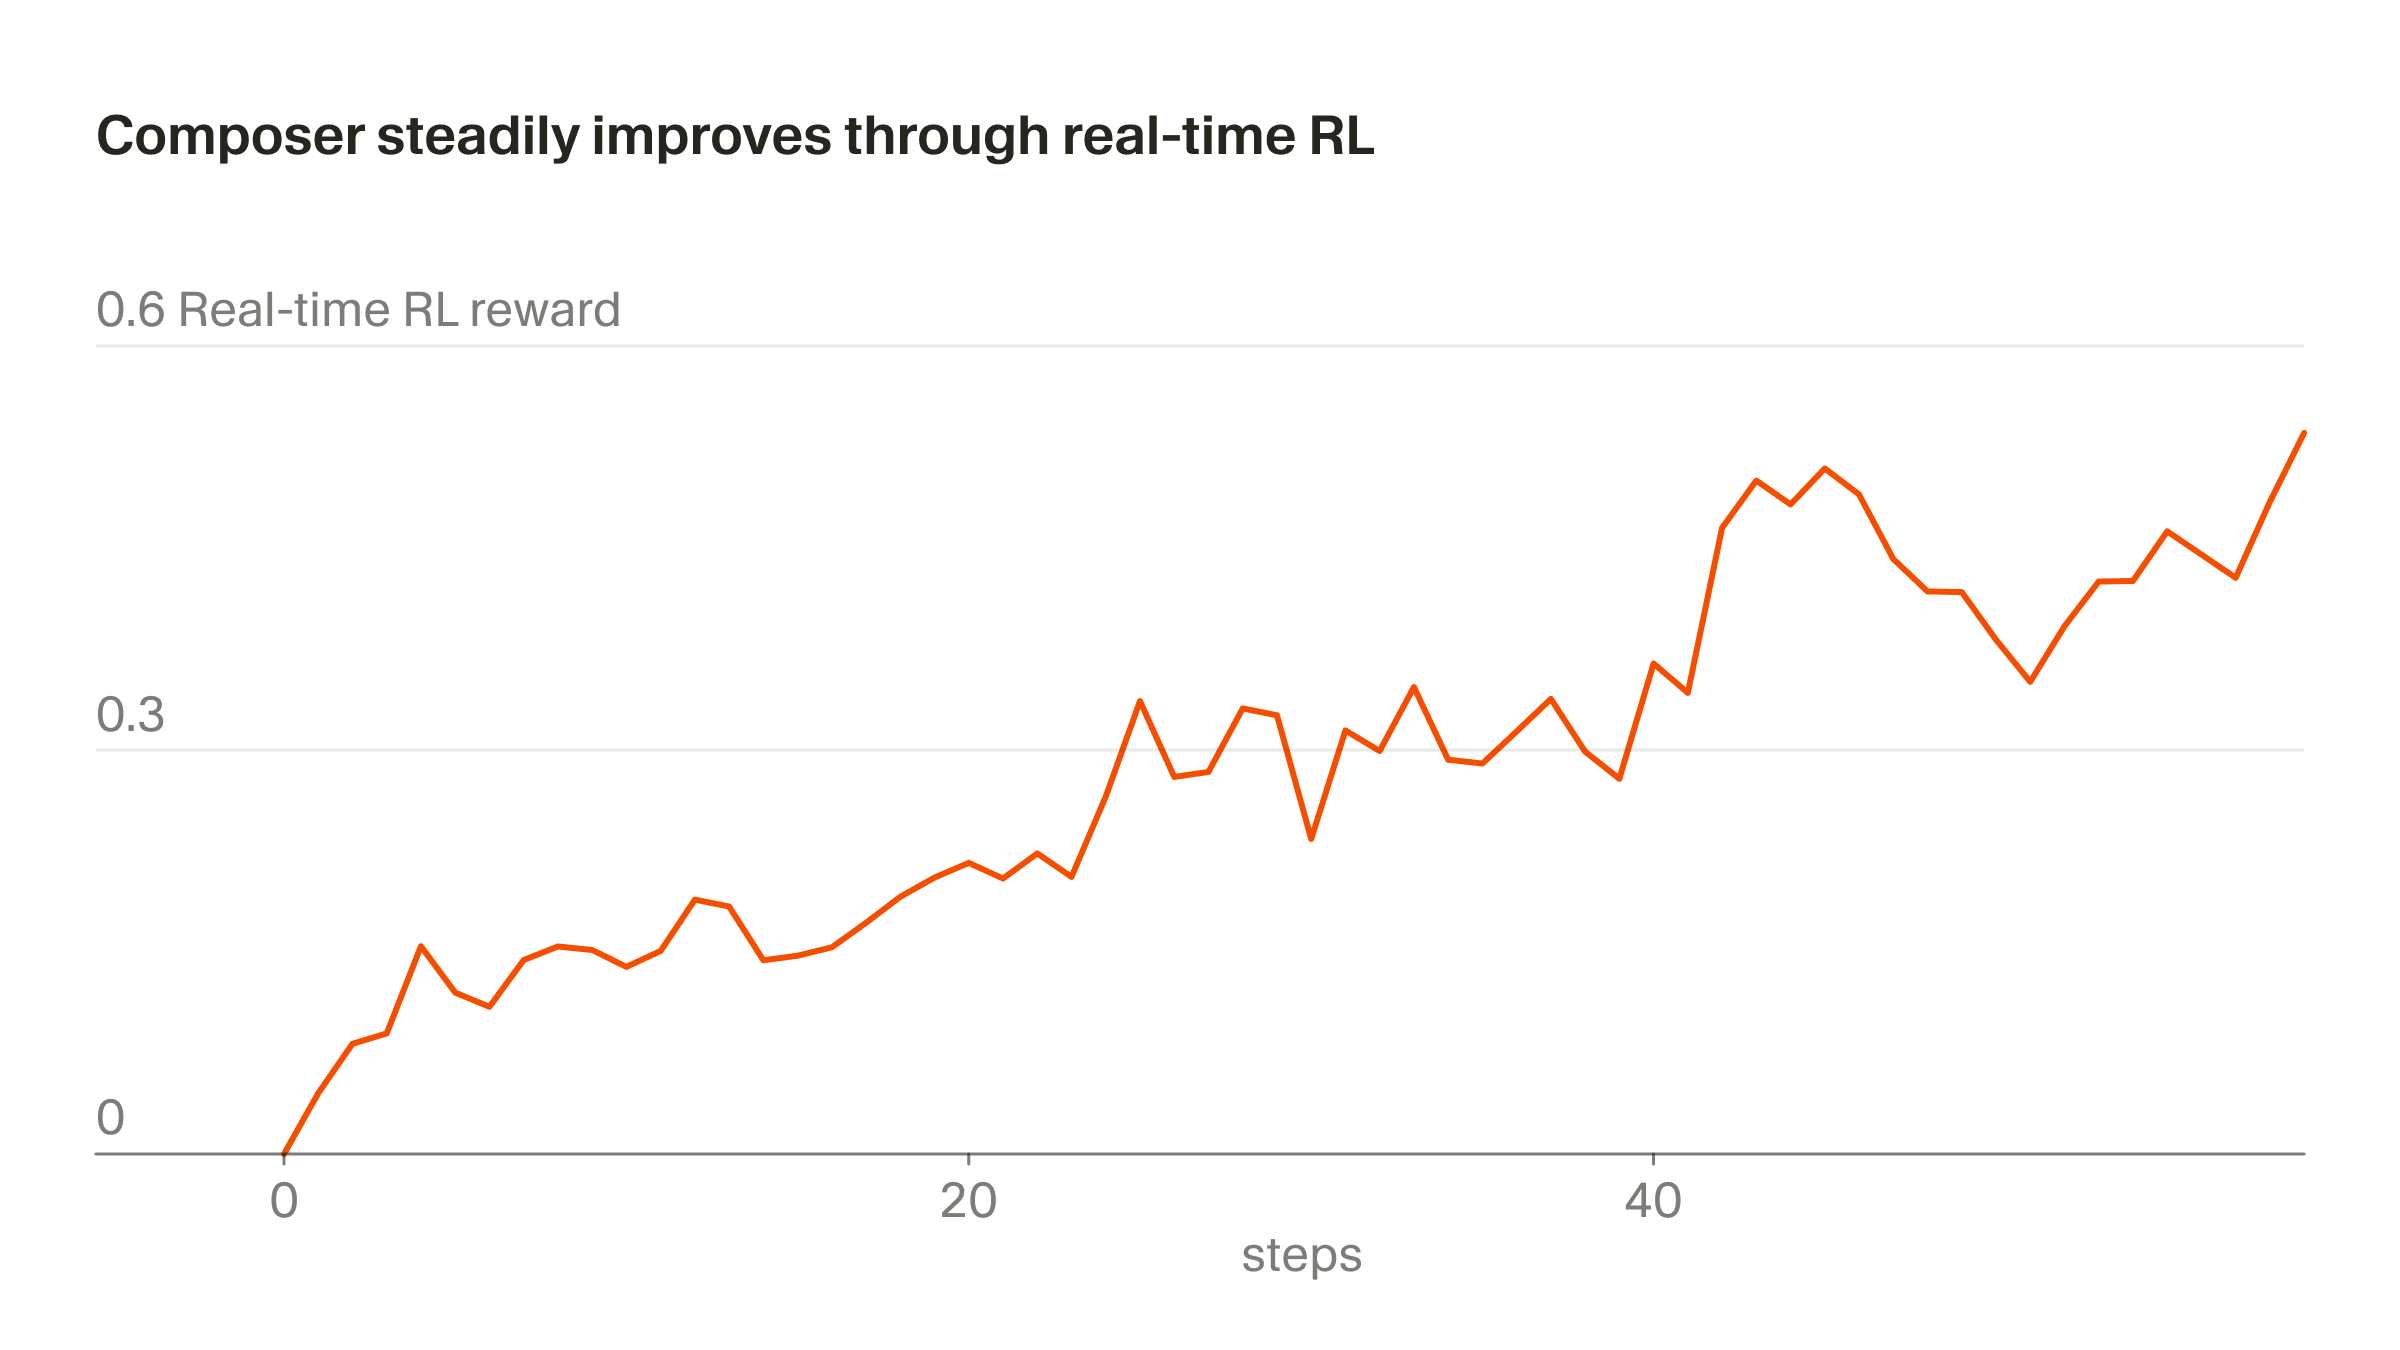
Cursor 先通过 IDE、真实代码仓库、工具调用和用户交互掌握高保真环境,再基于开源底座进行 continued pretraining 与大规模 RL。Composer 2 的 RL 直接复用部署时的工具和 harness。
2026 年 3 月,Cursor 披露 real-time RL:从生产交互提取奖励,完成训练、回归评测与部署的周期约五小时。这个案例说明,产品环境可以成为模型公司的上游训练资产。I8I9
端到端芯片设计与模型—硬件共演化要求控制权重、训练分布和推理系统。早期仍可用通用模型补充代码与规划,但长期 thesis 已把模型所有权写入核心。
AI R&D 全流程会产生专有实验轨迹,适合训练擅长研究任务的模型。是否从头预训练取决于外部底座在长时研究、工具使用和许可上的瓶颈。
新学习算法、持续学习与新架构就是公司研究命题。若始终依赖外部模型,它只能证明自动化工具,无法证明自身宣称的范式变化。
Financing narrative
三家公司尚未形成可用收入倍数解释的估值。资本定价围绕人才稀缺、范式跃迁概率、算力供给和潜在市场重写展开。
Ricursive Intelligence
融资叙事从 AlphaChip 的生产前史出发,连接到芯片研发的高成本、长周期和全球人才缺口,再把终局推向 workload-to-chip 与模型—硬件共演化。
Mirendil
核心叙事强调团队亲手构建过自动 AI 研发系统,并判断模型巨头不会把同类能力完整出售给潜在竞争者。Mirendil 因此占据中立的 AI R&D 平台位置。
Core Automation
故事从现有预训练、强化学习和 transformer 的局限出发,把持续学习、新架构与 Agent-first 组织组合为一个高方差期权。创始人的 OpenAI 推理模型经历提供初始信用。
The Nvidia capital-compute flywheel
Ricursive Intelligence 与 Mirendil 的 Nvidia 参与由官方或投资方披露;Core Automation 的早期轮参与来自媒体与 Forge 数据,7 月新投资方尚未披露。由此可以推断一条产业逻辑:战略资本帮助新实验室更快获得融资与算力,新增资本又扩大 Nvidia 生态中的计算需求。它提高了创业公司的启动速度,也增加了单一供应商依赖。I10
Agent 是否能自主提出问题、运行实验并写回权重,还是只自动执行创始人定义的任务?
用哪些反事实、人工复核和生产结果发现 reward hacking?失败案例是否进入训练?
数据来自真实客户和真实工具,还是可以被任何模型公司用公开 benchmark 复制?
自有模型带来的准确率、速度、成本或数据控制提升,能否覆盖训练与运维成本?
隐私与 IP 边界是否允许模型从多个客户学习,还是每个项目都需要隔离交付?
融资中有多少转化为预付 GPU、云承诺和低利用率风险?供应商是否附带投资条件?
在 Google 或 OpenAI 内部成功的系统依赖哪些专有数据、基础设施和团队?新公司是否拥有替代品?
模型、客户、流片、benchmark、实验吞吐或收入中,哪一项会把叙事转成可观察事实?
China implications
美国市场已经把“自动研发 + 自有模型 + 新型实验室”组合成独立融资类别。中国市场更可能先从环境密集的垂直领域出现,再逐步上移到模型训练。
分析推断 基准情景下,国内投资人会在未来 6–12 个月更频繁地以“Loop 是否闭合”评价 AI for Science、芯片、代码、机器人和工业 Agent 项目。估值抬升需要至少一个本土项目证明:真实环境能产生高质量奖励,并持续改善模型或系统。
代码、芯片、游戏、仿真与部分工业流程拥有高频可执行反馈,最容易率先形成可训练的闭环。
控制软件界面还不够。公司需要进入客户任务、数据、工具与结果,才能建立外部模型拿不到的轨迹。
先验证环境和 reward,再投资后训练与领域模型。基础模型预算应对应明确的能力或成本瓶颈。
把 Agent 重试、人工运营或 prompt 优化包装成 recursive self-improvement,无法形成持久训练资产。
复杂供应链、本地工具与工程 know-how 提供环境壁垒;同时要处理客户 IP 隔离和长反馈周期。
客户若担心研究数据泄漏给模型供应商,中立的多模型平台可以获得独立位置。
美国公司的战略投资与 GPU 供给联动难以直接复制,国内项目要更早证明训练效率和计算替代方案。
第三方 benchmark、客户续费、自动实验吞吐和模型更新频率,比宏大的 AGI 终局更适合阶段性定价。
把产品当成训练系统设计:记录任务分布、工具调用、用户修正、失败原因和最终结果;从第一天建设可重放环境与回归 eval。模型供应商可以替换,训练数据的形成机制更接近长期所有权。等到这些信号稳定,再决定后训练、continued pretraining 或完整预训练。
Method & sources
私营公司融资与研发信息不完整。本报告将公司公告、技术原文、投资方文章、主流媒体和分析推断明确区分,并保留可点击原始链接。
融资额与估值优先采用公司公告;没有公司公告时采用公司文件数据库与 The Information、TechCrunch 等媒体的直接报道。Forge 的 post-money 数据注明依据公司提交的 Certificate of Incorporation,但其页面同时声明未进行独立审计。投资方文章用于理解 thesis 与团队经历,不等同于独立技术验证。所有对商业模式、竞争和中国市场的判断均属于分析推断。
三家公司均为早期私营企业,无统一财务披露。Core Automation 的 7 月融资尚未由公司宣布,Forge 也声明其数据未经独立审计;Mirendil 与 Core Automation 尚未提供可独立验证的公司级 benchmark;Ricursive Intelligence 的 AlphaChip 证据属于创始团队前史,不能替代公司产品验证。